Kengo's blog

Technical articles about original projects, JVM, Static Analysis and TypeScript.

Not everything is a stream

10年ほど前、業務システムがあるべき姿を追い求めて Reactive Manifesto に行きつき、 reactive programming に傾倒していたことがありました。Vert.x を使ってすべてをイベントの流れであるとみなしたコードを書き、backpressure で全体の負荷を制御しつつ、ハードウェアを使い切れるソフトウェアを実現できるのではと思っていたのです。。単純な並列処理・並行処理に比べて思想としては背骨を感じるし、CompletableFuture やProject Reactorなんかも出てきていい感じだなと思っていました。

……ええ、思ってはいたんですが、例外もイベントとして扱うためにどうしても try-catch ベースのハンドリングに比べて異常系処理の見通しが悪くなりやすく、単に RDBMS から取り出したデータをストリームとして扱いたいだけなのに複雑なおまじないが必要だったり、ページング処理の書き方を検索しても見つけにくかったりと、難しさに直面してフェードアウトしてしまいました。

blog.kengo-toda.jp

blog.kengo-toda.jp

とはいえ並列処理・並行処理のニーズが消えたわけではないので、どのような書き方に落ち着いていったかというと、Kotlin の suspend や Java の Virtual Threads のような逐次的な制御構造を保てる書き方です。JEP 444 に書かれているこの課題意識がまさに当時の自分の意見を代弁してくれているように感じます:

They thus forsake the language's basic sequential composition operators, such as loops and try/catch blocks.

なんでこんな話を急にしたかというと、最近 Write-Ahead Logging から別インスタンスでのデータ更新を再現するという、リードレプリカ的な機能を趣味で実装していたんですが、そこで Flow が出てきたんですよね。自分の中では structured concurrency が有力になって、everything is a stream という夢から離れても、あるところにはきちんと stream が流れているんだなぁというか。色々知って使い分けることにしっかりと価値があるんだなぁというか、そういうことを考えたのでした。

GSS における不正アクセスについて、報告書に期待すること

piyokango さんのブログでまとめてくださっていますが、昨日デジタル庁のガバメントソリューションサービス(GSS)への不正アクセスについての情報が公開されています。

piyolog.hatenadiary.jp

一次情報としては9月11日会見の2:29ごろから、ないしデジタル庁ウェブサイトが該当します。なおウェブサイトの方は本日(9月12日)にもQ&Aが追記されているので、昨日読んだ方ももう一度確認されると良さそうです。

医療業界では公立病院のランサムウェア事例報告書が多くの方々に検討されることで、公的ガイドラインや政策にフィードバックされたと理解しています。今回の事例もいずれ報告書がまとまると期待していますし、そこでは次のような観点が盛り込まれ検討されると良いなと思っています。

1. なぜ侵入を約1か月検知できなかったか

5月下旬ごろから侵入していて、検知が6月25日ということは、1ヶ月近くの期間侵入状態にあり、何らかの活動を行っていた可能性があります。

攻撃者が対象ネットワークに長期間潜入することがある、とは良く聞く話で、だからこそ短時間だけログを残すような運用は改めるべきとも言われます。この1ヶ月がまさにそのような潜伏期間だったのか、それとも単に気づけていなかっただけなのかは、振り返りが必要だと考えます。

また調達情報からは、少なくともSOCサービスの仕様としてSIEM等を用いた監視・調査が想定されていたことが確認できます。その運用や設定に改善点があったかどうかも議論したいところです。

2. 6月25日の検知から7月9日の外部通信遮断までの14日でどのような暫定的な被害拡大防止措置を講じたか

ここは時刻付きでタイムラインを洗い出し、調査や意思決定に課題があったかを洗い出すべきところだと思います。発表では検知直後から被害拡大防止措置を講じたとしているわけですが、その具体的内容は何だったのか。また、その段階では当該アカウント停止や侵害機器の外部通信遮断を行わず、7月9日に実施した判断過程はどうだったのか。ここが報告書の核心になる部分だと思います。

3. 脆弱性管理の意思決定過程

脆弱性をいつ認知し、どんなリスク評価をし、誰が「今すぐ適用しない」と判断したのか。パッチ適用予定はいつだったのか。他の脆弱性より後回しにした基準は何で、それは異常が確認された6月25日以降も変わらなかったのか。などを洗い出すことが重要だと考えます。おそらく「ここでこの判断をしていれば…」というポイントが複数あるはずで、そのうちどこが最も費用対効果が高いのか、また確実性が高かったのか。そういった情報があるだけで、似たような組織課題を持つセキュリティ担当者にとって説得材料として活用しやすい報告書になるはずです。

個人的には GSS の運用保守を受注した事業者とSOC/SIEM を受注した事業者とが異なることから、複数の事業者に役割が分かれる中で、誰が横断的なリスク評価と優先順位付け、対応判断を担う設計だったのかにも関心があります。そのあたりの責任分界点が合意できていたのか、できていたなら運用に課題はなかったのか、できていなかったのなら契約をどう整理することが望ましいのか、が報告書から見えてくると良さそうです。

4. 攻撃チェーン全体の分析

ゼロトラストネットワークアーキテクチャを採用しているGSSで、VPNへの侵入後、どのような認証・認可の境界を越えて情報取得に至ったのか。VPN 脆弱性に加えて何によって保守アカウントの悪用につながったのか、一連の流れを追うことで多層防御の勘どころを国として学ぶ機会になると良さそうです。

また脆弱性によっては VPN 接続を多要素認証化していてもすり抜けられてしまっていた可能性があり、多要素認証さえしていればヨシ!のような新しい境界防御(造語、多要素認証という単一対策への過信)に対する戒めとしてわかりやすい話になるかもなと思っています。

5. 利用機関間の分離と保守アカウントの権限設計

侵入後に保守運用担当者のアカウントを利用できたとして、そのアカウントは保守のためにファイル内容にアクセスする必要性があったのか、理想的にはどのような権限を保守アカウントに渡すべきだったか、などが議論されると良さそうです。

また、複数の利用機関にまたがって情報へ到達できたのであれば、利用機関間の論理的な分離がどのように設計され、今回それがどこまで機能したのかも知りたいところです。最小権限やネットワーク分離など、設計に反映できる知見が多く得られるのではないかと期待しています。

6. 漏えい可能性があると判断した根拠

デジタル庁では不正アクセスの痕跡が確認された情報について、漏えいを否定できないものも含めて対象としたと説明しています。では、どのような痕跡をもって対象ファイルを抽出したのか、ファイルアクセス・外部送信・ログ欠損など、証拠の確度をどのように分類したのかここがきちんと報告書で共有されると良さそうです。どのような監視に価値があったか、なかったか、どこにコストを掛けるべきかという検討の材料が得られるのではないかと期待しています。

7. 再現・計測可能な再発防止策

「脆弱性管理を見直す」のような抽象的な話ではなく、具体的に再現・計測できる再発防止策があると良さそうです。今回はCVSS評価に注目が集まっていますが、専門家が現場に入れば他の改善点も見えてくるのではないかと期待しています。

特に今年度末ごろからSCS評価制度の★3・★4の申請受付開始が予定されているため、システム構成部品の脆弱性管理について今ベストプラクティスを構築できれば、その学びを広い業界・組織に定着できる可能性があるかもしれません。

以上です。せっかくの機会ですから、広い業界・組織に適用可能な学びにできると良いなと思っています。

「学習する医療システム」についてのメモ

医療機関に Continuous Integration(CI) の概念を持ち込めるのか調べていたら、Continuously Learning Health Care System という概念があることを知りました。その問題提起はだいたい次のように要約できます:

著者たちは、心筋梗塞後のβ遮断薬を例に「有効な医学的知見が得られても、それが日常診療に定着するまで非常に長い時間がかかる」という問題を示しています。1982年には死亡率を少なくとも25%低下させることが示され、その後も有効性が確認されたにもかかわらず、1990年代半ばでも使用率は30〜50%程度でした。ガイドライン、品質指標、P4P、改善キャンペーンなどを総動員した結果、ようやく一般的な診療として定着しますが、最初の研究結果からそこまで約25年かかりました。 著者たちは、これは個々の医療者が勉強不足だから起きるのではない、とかなり明確に述べています。新しい臨床試験、論文、ガイドラインなどの情報量は、一人の人間が継続的に読み、理解し、診療に適用できる能力をすでに超えています。そのため「医療者に最新知識についていくよう、もっと努力させる」という方法では医療の質は改善せず、むしろ不要な負担とストレスを増やすだけだ、としています。

この報告書では正しいことを容易に実行できるよう医療システムそのものを設計することが必要だと主張しているようです。診療の経験から知識を得て、その知識を次の診療に戻し、そこからさらに学ぶという循環を医療システムが持つという発想です。

この構想はその後ひとつの研究領域として発展していて、 2025 年には学習する医療システムに関連する研究群を統合したシステマチック・レビューが出ています。継続的に議論されているのがすごい。

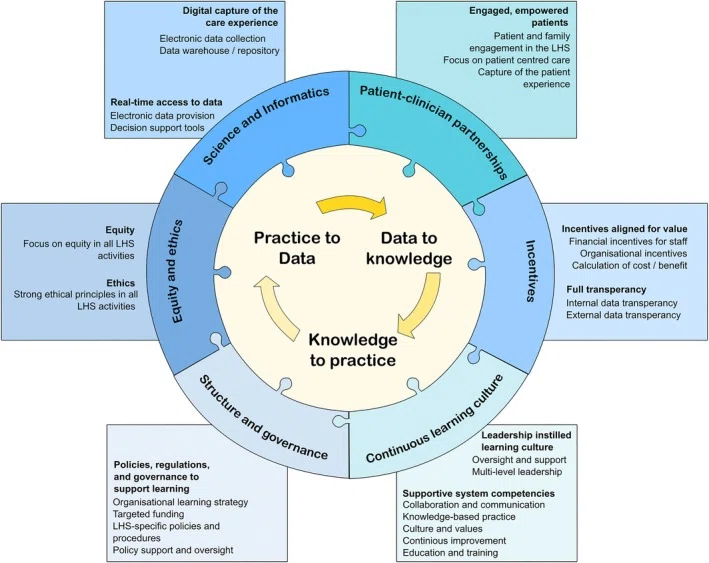
このシステマチック・レビューでは学習する医療システムを構成する主要な6領域を整理しています:

  1. 科学と情報基盤(Science and Informatics)
  2. 継続的に学び、改善する文化(Continuous Learning Culture)
  3. 患者と医療従事者の協働(Patient–Clinician Partnerships)
  4. 改善を促す仕組み(Incentives)
  5. 組織体制とガバナンス(Structure and Governance)
  6. 公平性と倫理(Equity and Ethics)

「忙しい医療者に改善という追加業務を積むな。通常業務そのものが学習するよう設計せよ」という主張が学習する医療システムの根底に流れていて、とにかく仕組み(システム)で解決しようと言っているところは DevOps の流れにも近いものを感じます。

2025年論文より引用。6つの要素によって 実践→データ→知識→実践… というループが回る

ということで、CI という概念を持ち込めるのか調べていたら、すでに別の近しい文化が存在していたというオチでした。文化定着が一番重要で難しいのは SRE や DevOps に携わるものとしては容易に想像つくところですが、こういう考え方が他業界にもあるのだということを確認できたのはとても良かったですし勇気づけられました。

IT と OT とを包含する総体としての医療機関におけるシステム

先日 OT(Operational Technology)について学ぶ機会があり、そこで IEC 62443 について知りました。これを知ったときの最初の気づきは「あれ、医療情報システムもIEC 62443適用対象と考えられるんじゃないか?」でした。

本来の IEC 62443 適用対象としては IACS(Industrial Automation and Control Systems:産業用自動制御システム)です。一般的な医療情報システムを一括してIACSとみなすことはできませんが、部分部分に IACS/OT 的な制御システムを有しますし、次に挙げる共通点を持つためにかなり近い存在であると言えると私は考えました:

  • 医療機関内部にも医療機器や機器間連携といった制御が多く存在する点
  • 情報の世界と物理の世界とが両立されてはじめて運用が回る点
  • ネットワークを「Zone」と「Conduit」で考えることの価値が高い点
  • 可用性や安全性が重要である点、提供者の異なるシステムが多数組み合わされて稼働している点
  • Asset Owner が最終的な Accountability を負うという点
  • BMS(ビル管理システム)や HVAC(空調換気設備)などは IACS/OT 的な制御システムに該当する点

一方で次のような違いもありますし、総体として IACS/OT だとは言えないのが実際だと思います:

  • 長期運用されるIACSと比べ、医療情報システムでは、構成するハードウェアやソフトウェアの一部が比較的早期に保守終了を迎えることがある点
  • 多職種連携が前提の環境ということもあり、ユーザの IT リテラシーに多様性がある点
  • 診療報酬改定、薬価改定、医療DXプラットフォーム対応など、短期的に対応すべき変化が多数波のように押し寄せる点
  • 遠隔診療や訪問診療など、システムを使う場所に多様性が求められる点
  • 医事会計、電子カルテ、予約管理、文書管理などは IACS 的な存在とは言えない点

実際関連規格を紐解くと、IEC 62443-4-1 のセキュア開発ライフサイクルを医療ソフトウェア向けに適応した規格として IEC 81001-5-1:2021 が存在しているので、OT と医療情報システムは全くの無関係とは言えないようです。

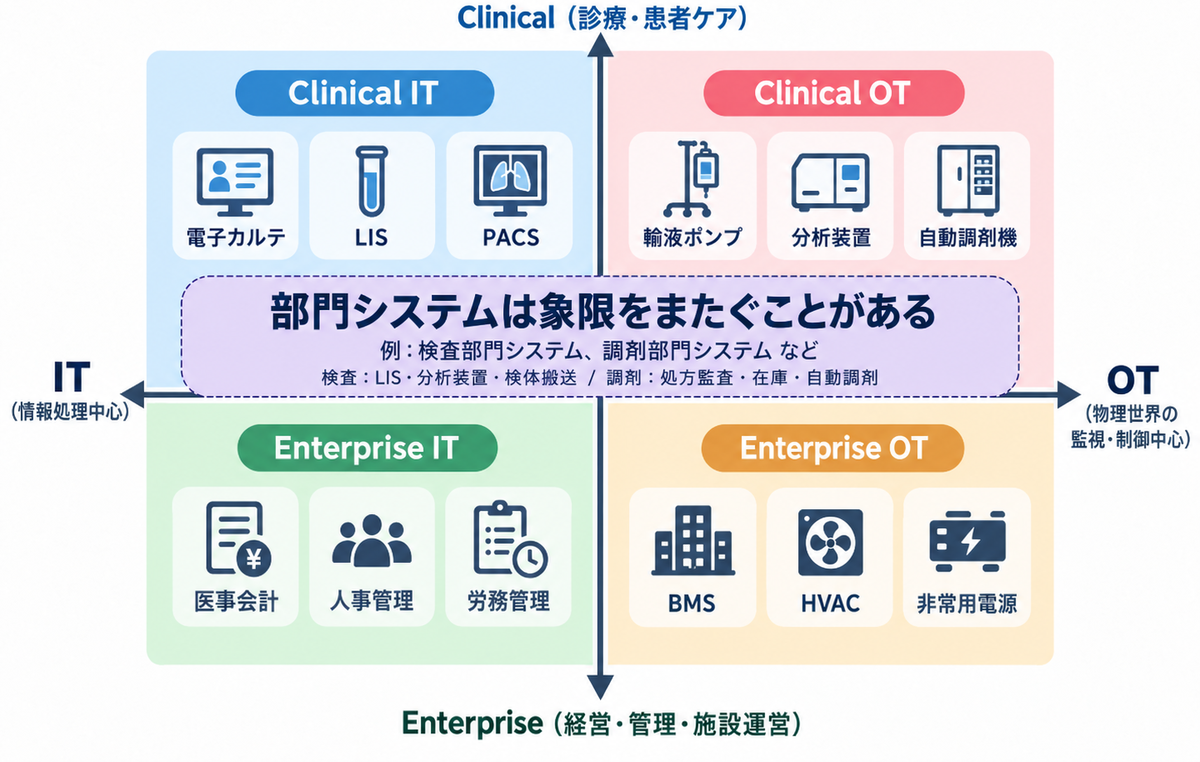
ちょっとまだ整理しきれていないのですが、医療機関にあるシステム(医療情報システムを含むが、それに限定されない)は概ね4種類に分けられるかなと個人的に思いました*1:

図1 医療機関のシステムを4象限で整理したもの

もともと医療機関のシステムが異なるシステムの集合体であることと、リスクを評価しながらそれぞれを接続・連携することの難しさとは認識できていたのですが、今回 OT という存在とそれを扱うための方法論とを理解できたことで、システムを新しい目で見られるようになったと感じます。IT 側事業者と OT 側事業者の観点の違いの理解や、システム境界ではなくZone / Conduit でものを見ることの重要性の理解などは、今後役立ちそうです。 Guide to Operational Technology や JIS T 81001-5-1:2023 も時間を見て読んでいこうと思いました。

*1:ここで言う「Clinical」は3省2ガイドラインが言う「医療情報システム」ではありません

医療情報システムの今と未来について思っていること2026

年度が切り替わったタイミングで、医療情報システムの今と未来について思っていることをまとめておきます。

公開情報をもとにした私見です。筆者は医療情報技師&情報処理安全確保支援士(登録番号028693)ではありますが医療業界に来てまだ短い若輩者ですので、お気付きの点があれば Twitter (X) アカウントまでお寄せいただけると嬉しいです。

医療DXというビジョンを国が掲げる難しさ

高齢者の増大などに伴い介護や医療の需要が増大していく一方で労働人口が減少するという事実や、コロナ禍で経験したいわゆる”デジタル敗戦”の経験をもとに、国では医療DXを進めている、と認識しています。特に直近では医療DX令和ビジョン2030を掲げています。ただDXといえばシステム化や情報化以上に運用の見直しが重要であることが以前から言われていますが、国のような大きな枠組みでそこまで踏み込んだ議論には事実上できていません。

たとえば先月末に公開された電子カルテやレセコンの標準仕様にも「医療機関における標準的な業務フローを規定するものではない」と明記されてしまっています。医療機関ごとに目指す医療が異なる以上、標準フローを規定することそのものが難しいというのは一定あるとはいえ、最初から白旗を上げている印象を持ちます(全国医療情報プラットフォームとの連携を仕様に盛り込むことで、将来の可能性を残しているようにも見えるか)。
他の事例として診療報酬周りでは、複雑化した診療報酬や負担額の算定をリファクタリングするという発想ではなく「共通算定モジュール」によってシステム改修の機会を減らすという発想になっていて、現行の制度や運用にメスを入れにくいためにシステム化やデジタル化にフォーカスが当たりがちな現状を色濃く映していると感じます*1。

このように医療DXの牽引を国がやることには一定の難しさがありそうです。そもそも医療の実態はデータ化されていない領域が多く、またデータ化されていても他のデータベースと連結が必要であり、全体が把握できていないことも多いようです。こういった問題もあり、まずは可視化を兼ねて情報化を推進しているのが状況と理解しています。

2030年までに電子カルテの普及率を約100%にするとしている

こうした変化には強力なリーダーシップと充分な財源が必要です。しかし現在の日本では充分な財源はあてにできませんので、資金を効果的に使ってリーダーシップを発揮していくことが求められます。国は電子処方箋と電子カルテ・共有サービスの一体的な導入を進めて「患者の医療情報を共有するための電子カルテを整備するすべての医療機関への導入を目指す」としており*2、そのために「2026年夏までに、電子カルテ/共有サービスの具体的な普及計画を策定する」としています*3。先日クラウドネイティブ型電子カルテへの補助金も出ています。

消費税変更が検討されるたびにレジなどのシステムの改修が大変だという話題になりますが、理屈の上ではすべての医療機関が更新しやすいクラウド電子カルテを使うようになれば、こうしたシステム都合の縛りは減ります。また全国医療情報プラットフォームとの接続性も改善されるので、国が各種情報を把握しやすくもなっていくでしょう。政策の検討と実施のサイクルを高速に回せるようになるはずです。

ただ普及率約100%はかなり挑戦的な目標だと考えます。2023年の調査では2,427(34.4%)もの一般病院が電子カルテを使っていない状態でした。本格的な普及施策が2026年夏から加速すると仮定し、また電子カルテの導入には1年近くかかるケースがある=2029年春が実質的なデッドラインと考えると、4年分の時間と予算、そして1度の診療報酬改定で2,000近い医療機関に電子カルテを入れることが求められます。これは、結構難しいんじゃないかなと。電子カルテを入れない判断をする医療機関に強いディスインセンティブを設けるか、電子カルテを入れることによる強いインセンティブを設けるかが必要になりますが、電子カルテという基幹システムを入れることは人材・体制・設備すべての面において投資が必要です。後述しますが特に人材の確保と受入れのための体制づくりがこの短期間では難しいように思います。

2023年時点で約2,400の一般病院が電子カルテを使っていない

医療情報システム人材の確保・普及は難しい

以前未来投資戦略2017で2020年までに400床以上の一般病院における電子カルテの普及率を90%に上げるというKPIを設定しており、実際2020年にこれは達成されました。その点では実績ある挑戦とは言えるのかもしれません。

しかし今回は中小病院も対象となっています。中小病院は数が多いことに加え、特に小規模医療機関では情報システム部門が存在しないことに留意が必要です。今回の診療報酬改定では医療情報システム安全管理責任者が情報セキュリティマネジメントや情報処理安全確保支援士の資格を有していることが望ましいとされるようですが、そんな人は小規模病院にはまずいないでしょう。ちょっとパソコンに詳しい人がシステムを見ていたり、事業者に完全に丸投げる体制になっていたりして、主体的に情報化や医療DXを進めることが難しくなっています。

「病院における医療情報システムのサイバーセキュリティ対策に係る調査」7ページより

ではそうした能力を持つ技術者が今後小規模医療機関で採用されるかというと、難しいでしょう。一般に医療機関の情報システム部門の待遇は良いとは言えず、いま会社で働いている経験ある技術者が病院で働くことを決断することは特別な事情がない限り難しいのではないかと思えます。もちろん新卒採用で入ることも、報酬面だけから考えても少ないかなと……。

これについては国もすべての医療機関に医療情報システムの専門家が専任する未来は思い描いていないようで、小規模医療機関にはITパスポートレベルを一つの目安とした基礎的なITリテラシーを持つ担当者を置いて、コンサルや他の医療機関の人材が顧問となったりセキュリティチェックを行ったりという体制を目指すことが「安全な地域医療の継続性確保に資する医療機関における情報セキュリティ人材の育成と配置に関する研究班」によって提言されています。ID管理や端末台帳管理なんかをメインとして、NWやシステムの設計は他に任せる体制となるようです。

「医療分野における持続可能な情報セキュリティ人材育成と継続的雇用・配置・キャリア形成等に関する提言」より

同じく「医療分野における持続可能な情報セキュリティ人材育成と継続的雇用・配置・キャリア形成等に関する提言」より

この提言には少なくとも各都道府県に1施設は「指導的な立場の医療機関」の配置を目指すと書かれていますが、「支援」が施設基準等を通じて収入に貢献しない限りは難しいのではないかと思えます。逆に言えば補助金なり診療報酬設計なりで充分な動機づけを行うことが推進の鍵になるはずで、特に採用は長期にわたる投資判断ですから、補助金よりも診療報酬設計によって補われるべきと考えます。2028年の診療報酬改定で、どこまで医療情報システムや情報セキュリティがわかる人材が重視されるか?がひとつ未来を占う鍵になるのではと思います。

この体制が実現すると、高い専門性を持つ人材なしで投資判断やガバナンスをきかせることが求められる経営(医療情報システム安全管理責任者)の責任がより重大になるでしょう。院長や事務長などの皆さんの説明責任はますます増えそうです。またGroup Aの担当者が他院のシステムの全体像を容易に把握できることが求められることから、Group CやGroup Bが使うシステムにおいても高いレベルの統制が求められるのではないでしょうか。誰が管理してるかわからないVPNサーバがそのへんに置いてある、みたいな体制はより説明がつかなくなっていくかなと。端末台帳管理もそうですが、ID管理の決定版みたいなのが欲しくなりますね。医療機関はけっこう認可周りが細かいのと短期バイトの存在、共有端末の存在が特徴的だよなと感じています。

落としどころとしてこうなるんじゃないかという想像

という感じで様々な困難さが横たわってはいるものの、少しずつデータが集まるようになれば日本における医療機関経営の型が見えてくるはずです。また全国医療情報プラットフォームや「指導的な立場の医療機関」が整ってくることで、より「日本における医療機関の医療情報システムはこうあるべき」がパターン化されるようになるでしょう。こうなるとハードウェアからネットワーク、ガバナンスに職員教育まで含めたパッケージ提案が現実的になっていくので、というか小規模医療機関にはネットワーク機器や利用端末を選定する能力が備わらない前提が共有されるので、ネットワークやインフラの事業者はより広い範囲を自らの責任分界に含めていくでしょう。これによって医療機関はより「所有から利用へ」を推し進めやすくなるのではないでしょうか。国が電子カルテやレセコン周りでAPI連携の標準仕様を考えようとしているのも追い風です。

逆に責任分界点が明確にできない医療機関や、Group Cの人材すらも確保ができない医療機関では、合理的なコストでの情報化やDX推進ができなかったりサイバーセキュリティ上のリスクが高い状態が続くことになるでしょう。医療サービス以外の局面でも淘汰が始まるのかもしれません。

まとめ

国は医療DXを実現するための情報化を進めている状況にありますが、2030年までにこれを終えるのはかなり強いリーダーシップと充分な動機づけがないと難しいのではないかと感じます。そしてそれは補助金の設計以上に、2028年の診療報酬改定が鍵になりそうです。2028年の改正までにシステムや統制のありかたが明確になり、Group Aを中心としたエコシステムが見えてくるのか?2030年までに情報化が進んでデータが集まり、いよいよDXの本丸に注力できるようになっていくのか?あたりを個人的には気にしていきます。

Agentic Coding用classファイル静的解析ツールをAgentic Codingで実装した

Rust 製の class ファイル静的解析 CLI inspequte を、Agentic Coding を開発の中心に据えて実装しました。結果として、人間がレビューするのは spec とテストケース、そしてリリース内容だけという運用に到達しています。

本稿で紹介するCoding Agent に多くを任せて人間はリリース内容確認に注力するワークフローを通じて、今後の Agentic Coding が目指すべき形がある程度見えてきたと思っていて、このツールのような Coding Agent が Definition of Done を判断するための CLI が洗練されるのではないかと思っています。

11年間追いかけた「ぼくのさいきょうの静的解析ツール」

FindBugs への貢献を始めたころの2015年に、静的解析ツールはこうあるべきだという理想をまとめたことがあります。その実現のために OSS の静的解析ツールを読んだり、その拡張を書いたり、数学的・技術的なバックグラウンドを理解するために学んだり*1ということを続けてきて2度スクラッチ開発に挑戦しましたが、いずれも当時の技術的限界や単純な開発量に圧倒されて未達のままでした。

それが今回 Agentic Coding の登場によって前提が変わり、非 JVM 言語で class ファイルの静的解析を書くハードルが急激に下がったことで、次のような課題が一気に解決されました。

  • 実行可能バイナリに直接コンパイルできる言語(Rust)で Java バイトコードを高速に扱うこと
  • Test Harness によって MCVE をそのまま回帰テストに使える仕組み
  • Kotlin と Java の両対応
  • control flow graph や data flow のスクラッチ実装
  • マルチコアを活かすための並列実行
  • 人間と Coding Agent に向けたドキュメントの自動生成
  • 複数ルールの開発を並行させてもコンフリクトを起こさないプロジェクト構成*2

さらにプロダクトのメンテナンスで必要になる配慮がプロンプトという形で保存・再生できるようになり、ひとりでプロジェクトを回すことのハードルも下がりました。 もちろんリリース内容に責任を持つのは引き続き人間がやるべきなのでリリース前レビュー工程は外せないのですが、静的解析は正解・不正解を仕様やテスト結果から判断しやすいこともあり、ルール開発のレビューはかなり任せられます。たとえば次のような内容をプロンプトやスキルとして保存しておくことで、一人で複数の作業を同時に実行したり、短い時間で進捗を作ったりという価値を出せています:

  • ルールの実装とテストにおける手順
  • ルール検討における観点
  • 仕様作成における観点
  • 実装における保守性の考慮と不具合を作りにくいテストの書き方
  • 実装評価における観点
  • 偽陽性を洗い出すプロセス
  • 複数プロダクトに対して静的解析を実行するスモークテスト
  • 同一条件で継続的に性能テストを実行して性能悪化を早期に把握する体制
  • 同一条件で継続的に他ツールとの性能比較をする体制

グラフにすると次のような感じです。青のところは Coding Agent をはじめとした自動化に任せられるところで、人間は緑の判断だけやるのと、赤のリリース承認だけやればよいという状況です。開発したルールの採用判断はまだ人間がやっていますが、判断基準が言語化できたらこれも自動化できそうです。

graph LR

%% ===== スタイル定義 =====
classDef auto fill:#E3F2FD,stroke:#1E88E5,stroke-width:2px;
classDef semi fill:#E8F5E9,stroke:#43A047,stroke-width:2px;
classDef manual fill:#FFF3E0,stroke:#FB8C00,stroke-width:2px;

class A auto
class B semi
class C manual

%% ===== ルール実装 =====
subgraph ルール実装
  企画 --> 計画 --> 仕様策定 --> 実装 --> 仕様と突合しての評価 --> 実装
  仕様と突合しての評価 --> 採用判断 --> mainに反映 --> ドキュメント更新
  企画 --> 不採用企画を記録して次に活かす
  採用判断 --> 不採用企画を記録して次に活かす
end

%% ===== 定期メンテ =====
subgraph 定期メンテ
  依存バージョン更新
  偽陽性調査と修正
  パフォーマンス低下要因の分析と修正
end

%% ===== リリース =====
subgraph リリース
  rev(リリース内容を整理) --> merge(リリース承認) --> rel[リリース]
end

%% ===== 凡例 =====
subgraph 凡例
  A[自動化可能(Agentに委譲)]
  B[半自動(人がトリガー・承認)]
  C[完全手動(人が思考・判断)]
end

%% ===== 分類 =====
class A,rev,実装,仕様と突合しての評価,mainに反映,ドキュメント更新,企画,計画,仕様策定,不採用企画を記録して次に活かす,依存バージョン更新 auto;
class B,偽陽性調査と修正,パフォーマンス低下要因の分析と修正,採用判断 semi;
class C,rel,merge manual;

AIを開発の中心に据えつつ人間がその説明責任を追うためのワークフローとして、この skill による自動化と人間によるリリース承認を中心に据えたやり方は筋が良さそうだと感じています。

で、ここまでだけなら「夢が叶いました!」なんですが、今回はもう少し風呂敷を広げて Agentic Coding 時代に求められる理想の静的解析ツールを追求しました。

Agentic Coding 時代に不要となったものもある

今回昔から思い描いていたツールを実現したと言っていますが、実際には必須と思っていた機能が不要となっている部分もあります。

2013年に FindBugs 関係の記事を書いたときは変更されたコードとその影響を受ける部分だけを解析する incremental analysis が必要だと思っていましたが、SonarQube のような巨大プロダクトですら10秒で解析できるようになるとシンプルに寄せられます。マルチコアを活かすための並列実行は重要ですが、複数ノードでの分散実行は大仰すぎました。Google Errorprone や Prettier が提供している自動修正はぜひ欲しいと思っていましたが、Coding Agent に十分な情報を提供できれば不要と判断しました。また IDE 統合も不要です。IDE を開発に使う頻度も落ちていますし、仮に使う場合でも Gradle 統合で乗り切れそうだからです。

なお Coding Agent が書いた Rust コードについては、人間はそこまで見ていません。人間は spec とテストケースだけ見るようにしています。共通コードに手を加える場合は既存テストケースを変えていないか厚めにレビューしますが、そうではない場合は spec が合理的で偽陽性検証のテストが書けていれば良しとしています。ルール変更の影響はそのルールに閉じるように設計することで、これを可能としています。つまりコードレビューもほとんど不要にできたということです。

Agentic Coding 時代、静的解析に求められること

Agentic Coding によって我々の開発サイクルはすでに大きな変貌を遂げています。 Coding Agent による PR レビューがすでに実用化され、人間も意識できていなかった観点を踏まえた高品質なレビューが安く早く行えるようになりました。 PR のレビューすら Coding Agent に任せて、リリースという意思決定を高速化しているチームも多いでしょう。

また Claude Code Security という、セキュリティ上の課題を高速かつ広範囲にわたって発見できるサービスも登場しています。不具合を中心に探してくれるBugbotもあります。静的解析を入れなくても、脆弱性や不具合を簡単に見つけられる時代になりつつあります。

さて、ではもう静的解析ツールは不要なのでしょうか?私はそうではないと考えています。静的解析の価値は「全自動マサカリ投擲機」であること、すなわちコードの品質を底上げるために「どこが問題か」「なぜ問題か」「どう改善できるか」を「めちゃくちゃ速く頻繁なスパンで」書き手に返すことです。そして Agentic Coding 時代でもこうした働きは次に挙げる2つの理由から引き続き必要です:

  1. Coding Agent には確実性が期待できないこと。品質底上げ効果にもムラがあるし、Coding Agent が書いたコードにも誤りが入る可能性がある。これは LLM の原理からも言えますし、複数のモデルやハーネスを組み合わせて利用することが一般的となっていることからも言えます。
  2. コードの書き手が人間から Coding Agent に変わっても「書き手にフィードバックを返す」ことの価値は毀損されていないこと。むしろテストやハーネスといった資産を整理することが重視されているように、フィードバックの価値は高まっています。

この2点を踏まえて考えると、いま必要な静的解析ツールは次のような特徴を備えているべきです:

  1. とにかく高速に実行できること。実行に数分かかってしまうようでは、Coding Agent の良さが活きないため。
  2. 結果が揺れないこと(同一入力に対しては常に同じ結果を返す)。
  3. CLI で動くこと。API や MCP を否定するものではないが、Coding Agent が変えたものの検証をその場で高速かつ少ないトークン消費で行うため。
  4. 出力が簡潔で Coding Agent にとって扱いやすいこと。

私は今回、こうした課題を次のようなアプローチで実行できると考えました:

  1. Rust で実装し、マルチスレッドを標準的に採用すること。
  2. ソースコード分析よりも多くの確定度が高い情報をもとにルールを適用するために、バイトコード解析を採用すること。
  3. CLI を実行可能バイナリとして頒布し、JRE のような前提を作らないこと。
  4. SARIF v2.1.0という Coding Agent が“常識”として知っているJSONベースの業界標準書式を採用し、その分析と解釈を助けること。

今のところこれらのアプローチは狙った結果を出しているように思います。Coding Agent からもビルドツール(Gradle)からも使いやすく、業務で開発する規模のマルチモジュールプロジェクトでも高速に分析して Coding Agent に対する入力として使えています。コーディングエージェントはプロンプトで明示的に教えなくても SARIF 2.1.0 を知っているので、SARIF ファイルを渡せば問題を理解して自分で修正してくれます。

実際どのくらい速いのか

「高速」を自称する以上、数値で語れるようにしたかったので、多くの静的解析ツールで実装されているNULLNESSルールに対象を絞って主要ツールと比較したベンチマークを公開しています:

ざっくり言うと、Guava 33.5.0-jre を対象にした比較では、inspequte の中央値は 0.250s で、同条件の nullness 系ツールに対して概ね 数倍〜桁違い の差が見えます(例:NullAway 1.234s / Checker Framework 1.314s / PMD 3.785s / SpotBugs 12.397s)。

また SonarQube 25.6.0.109173 を対象にした比較では、PMD 9.411s / inspequte 13.123s / SpotBugs 466.245s という結果になりました。比較対象や前提の違いもあるので詳細はリンク先に譲りますが、少なくとも「CI とローカルで何度も回す」用途でボトルネックになりづらい速度を狙って出せている、という手応えがあります。

他に試していること

ChatGPT による画像素材の作成も試しています。以前 99designs でプロダクトロゴを描いてもらったことがあるのですが、手間と資金が必要になるわりに思ったような結果は得られなかったんですね。ChatGPT なら当然レスポンスも早く、違ったときにやり直せるので、ズバリの結果が得られなくてもまぁ良いかなと思えるものにできました。ただ縦横のピクセル数だけは何度言っても変わらなくて、トリミング作業は自分でやっています。

ChatGPT に作成させたロゴ画像

ChatGPT に作成させた OGP 画像

また X におけるリリース通知の文面作成も任せてみましたが、こちらは「このリリースの目玉はそうじゃないんだよな〜」と思う結果が多く、結局文面を自分で作成して ChatGPT にレビューさせる運用になりました。

CHANGELOG の生成までは自動化できる(今回はモノレポに対応している release-please を利用*3)のですが、そのリリースに込めた思いのようなものは人間がまとめて伝えていく方法を採りたいと現状感じています。

静的解析以外の課題領域で同じアプローチが使えるか

今回実装だけではなく企画や仕様策定、評価までを Coding Agent に渡せたのは、静的解析やプログラミングにおける知識を彼らが元々持っていたからです。設計意図だけを書けばそれで十分で、data flow であるとか JVM stack であるとかの概念を教える必要はありませんでした。また入力や出力がほぼテキストとバイトコードという、LLM にとってもともと扱いやすいものだったのも今回の成功に強く寄与しているはずです。

これが Coding Agent が詳しくないドメインを扱うとか、人間などの不安定なインタフェースを相手にする必要性とかが生じると、コンテキストを伝えることの比率が上がって難度は上がるでしょう。それでも今後の技術発展によって扱えるコンテキスト量が増えるとか、サブエージェントの活用によってコンテキストを分割統治する体制を組むとか、Definition of Done をコマンドで検証できるようにしていけば、必ずできるようになるでしょう。特にこの「Definition of Done の検証」を CLI で高速に検証することの重要性は、今後静的解析以外のジャンルでも重視されると思います。個人的には品質目標とユーザインタフェースの評価についてこれができるようになり、人間の同期的な介入なしにプロダクトが成長する未来に関心がありますし、遅くとも年内には近い未来が見えるんじゃないかと期待するところです。

まとめ

Agentic Coding 時代の静的解析を再定義し、そのためのツールを Agentic Coding で実装しました。 人間は仕様とテストケース、リリース予定内容だけをレビューする体制になり、コードレビューも不要とすることで、 リリースの判断以外のほぼ全てを Coding Agent に任せられるワークフローが実際に構築できました。

こうした開発ワークフローを静的解析以外の課題領域でも構築できるかはまだわかりませんが、技術革新によってそれが可能になる未来はすぐに来るんじゃないかと期待しています。 その時に決め手になるのはコンテキストを分割統治する手法と、Definition of Done の検証を CLI で高速に検証する技術のはずで、関連する動きを追いかけていこうと思います。
*1:University of Aarhus の情報が役立ちました

*2:今回の静的解析プロジェクトの構成やプロンプトは次回掘り下げます

*3:リリース自動化については以前ブログ記事を書いています

CLIを書いてるなら、まずOTLPでtracesとeventsを吐けるようにするのがオススメ

とりあえず他の人に説明するのに良さそうなので、ChatGPTに書かせた記事です。


Agentic CodingでCLIを実装していると、機能要件がどんどん進められる反面、非機能要件がないがしろになりがちです。自分は最近静的解析CLIを育てているのですが、OpenTelemetryでtracesとeventsをexportできるようにしました。結果として「どこで遅いか」「どの実装が遅いか」を事実として掴めるようになり、最適化を迷わず打てるようになりました。さらにJargerを使えばスクリーンショットやJSONとして結果を取得できるため、人間はもちろんCoding Agentにとっても計測と改善のループを回しやすくなります。

traces(Span)とは

CLIの処理を「区間」に分けて、spanとして刻みます。例えば:

  • 引数解析
  • 入力列挙(ファイル探索など)
  • 入力の読み込み
  • 処理実行(処理ごとにspanを切る)
  • レポート生成
  • 出力(ファイル書き込みなど)

OTLPは、トレース・メトリクス・ログを運ぶための標準プロトコルで、Collectorや各種バックエンドに投げられます。CLIにexporterを組み込んで --otel http://localhost:4318/ などとcollector (Jarger)のURLを指定してやると、こうした情報がCLIのプロセスが終わった後もわかりやすい形で残るということです。イベント情報も紐づけて記録できるので、span処理中に何が起こったかをわかりやすく残しておくこともでき、ログファイルと突合しないと何がおこっていたか判断できない……みたいな状況も防げます。

Jaegerを合わせて使うと「記録」が一気に楽になる

OTLPで通信して情報を残しておくために、Jaegerをコンテナで立ち上げるのがおすすめです。Jaeger UIは、トレースを JSONとしてview/downloadできるので結果をそのままファイルに残せますし、スクリーンショットをPRやGitHub Releasesに添付しておくと人間にもわかりやすい形で改善を説明できます。こうした作業ももちろんCoding Agentに任せられます。

さらに最近、Jaeger本体に MCP(jaegermcp extension)関連の機能追加が入ってきていて、span名探索やcritical path取得など“エージェントから触りたい操作”が揃っていくと期待できます。ここまで来ると、パフォーマンス調査 → レポート化 → 評価、まで自動化できる見込みが立ちます。自分は現時点ではスクリーンショット撮影についてはスキル化しています:

github.com

なおJargerはログの表示に対応してないので、自分はOpenTelemetryをtracesとeventsに絞って利用しています。

Agentic Codingと相性が良い理由:ループが速くなるだけじゃない

Agentic Codingの開発ループって、だいたいこうなります:

  • エージェントに実装させる
  • 動かす
  • 遅い/失敗した/意図と違う
  • 直す

ここでOTelがないと、ループの途中で毎回こうなります:

  • 「多分ここが遅い」→ 当てずっぽう最適化
  • 「ログ増やすか」→ ログが増えて余計見づらい
  • 「再現条件なんだっけ」→ 記録がない

OTLPでtracesとeventsが取れると、ループがこう変わります:

  • 「遅い場所がspanで見える」→ 直す場所が確定
  • 「判断がeventで残る」→ 速さの理由が追える
  • 「JaegerのJSON/スクショをPRに貼る」→ 変更の証拠が残る

自分のケースでも、“観察できる状態”を先に作ったことで、並列化や最適化を適時に打てて、エージェントから気軽に呼び出せる実行時間に寄せられました。

まず最初の一歩(最小構成)

  1. CLIにOpenTelemetry SDKを入れて、トップレベルspanを1本切る
  2. 主要フェーズだけspanを増やす(入力列挙/読み込み/処理本体/出力)
  3. “判断”だけevent(ログ)で残す
  4. OTLP exporterでCollector/Jaegerに投げる(ローカルでOK)
  5. Jaeger UIで遅いtraceをJSON保存(またはスクショ)

この段階でも、「速さの議論」が体感から事実に変わります。